신기한 BoB 프로젝트들: LLM 기반 테스트 코드생성을 통한 퍼징테스트 자동화 솔루션 개발
이 글은 티스토리에서 옮겨온 글입니다.
1. 서론
최근 내 경험에 따르면, 역공학 및 퍼징 테스트를 LLM을 사용해 더욱 편리하고 빠른 취약점 분석을 수행할 수 있게 되었다. 대표적인 역공학 지원 LLM Claude 4.0은 보편적인 hex-ray도구인 IDA Pro와 MCP로 연결되어 바이너리 전체를 입력 데이터로 활용하고, 이를 기반으로 대화형 질의응답을 수행할 수 있다.
따라서 이 문서는 비교적 최근에 LLM을 사용한 자동화 분석 연구였던 Best of the Best 13기 팀 프로젝트 ‘LLM 기반 테스트 코드생성을 통한 퍼징테스트 자동화 솔루션 개발’은 과연 어떤 프로젝트였을까?를 바탕으로 이 프로젝트에서 예상되는 진행 과정과 결과물, 필요한 지식이 무엇이 있을지 조사해본다.
조사 내용들은 본 문서와 같이 보고서로 작성하여 공유하도록 한다. 그리고 해당 프로젝트에 대한 필자의 생각과 추후 연구 방향성을 제시해 보고자 한다.
2. LLM 기반 테스트 코드생성?
2.1. LLM?
| 대형 언어 모델(large language model, LLM)은 방대한 양의 데이터를 학습하여 자연어 및 기타 유형의 콘텐츠를 이해하고 생성하여 광범위한 작업을 수행할 수 있는 기초 모델의 범주이다. [IBM | LLM?](https://www.notion.so/e9e5a9d5be61444d87e0fb02e40cd3dd?pvs=21) |
보편적으로 가장 많이 사용되는 생성형 AI인 Chat GPT, Gemini와는 다르게 텍스트 기반의 결과물을 생성하는데 사용되며, 이로 인해 프로그램의 소스코드 등을 생성하는데 이점을 가질 수 있다.
2.2. 테스트 코드 생성?
보편적인 프로그램에 대한 퍼징 테스트는 그에 맞는 프로그램 또는 소스코드, 택스트 기반의 입력파일(Seed file)를 필요로 한다. 이러한 테스트 코드를 보안 전문가가 직접 작성하기에는 많은 시간과 어려움이 상존하기 때문에, 최근에는 진입 장벽을 낮추기 위해 퍼징 테스트 코드를 LLM을 이용하여 자동 생성하는 기법이 꾸준히 언급되어 왔다.
이에 관련된 논문을 조사해 보았는데, 2024년 KCI에 등재된 ‘FuzzGPT: 테스트 케이스 최적화를 위한 LLM 기반 프롬프트 엔지니어링 퍼징 기법’ [1] 논문은 LLM을 사용한 테스트 케이스 생성 방법에 대해 많은 연구 사료가 기록되어 있었다. 해당 논문에 관심이 있다면, 참고해 보길 바란다. (이 글도 해당 논문에서 많은 아이디어를 얻어 작성되었다.)
3. 퍼징테스트 자동화 솔루션?
퍼징 테스트는 타겟의 범주에 따라 다양한 형태로 존재한다. 프로그램의 형식에 따라 파일 형식의 입력, 통신 프로토콜 입력 등 다양한 형태로 수행될 수 있으며, 이에 오픈소스의 퍼저도 여러 종류가 존재한다.
또한 이 프로젝트는 자료조사 과정에서 프로젝트 산출물로 연구 논문[2]을 작성하였음을 알 수 있었다. 한국정보과학회 2024 한국소프트웨어종합학술대회 논문집에 기술되어 있으며, DBpia에서 유료로 구매할 수 있다. 판매 사이트에서 공개된 논문 AI요약본에 따르면 본 솔루션은 On-premise 환경에서 FE, BE, LLM 모델로 구성되어 있으며, 소형 LLM을 내부에 구성하고 LoRA 방법론으로 Fine-Tuning을 진행하였다고 한다. 이렇게 개발된 솔루션은 소스코드의 위험도를 제공하며, 기존 LLM API 대비 80%의 성능을 달성했다고 한다.
만약 DBpia의 논문 AI요약 말이 맞다면, 해당 프로젝트는 기존의 GPT, Gemini와 같은 기성 LLM모델을 사용해 개발한 것이 아니라 독자적인 LLM모델 환경을 개발했을 것이다.
4. 예상 진행 과정
개발 프로젝트이기 때문에, 일반적인 프로그램 개발 플로우와 얼추 일맥상통하게 흘러갔을 것이라 추측된다. 반면 이 중 내가 생각하기에 핵심적인 요소들은 다음이라 추측한다.
4.1. 타 솔루션 조사
Google의 OSS-Fuzz는 오픈 소스 프로젝트에 대해 자동으로 퍼징 테스트를 돌려 취약점을 탐지하는 플랫폼이다. 하지만 해당 퍼징 테스트도 언급된 문제점들이 발생해 왔고, 이를 해결하기 위해 LLM을 활용하여 자동으로 하네스를 생성하는 OSS-Fuzz-Gen이 개발되었다. 개발 프로젝트는 진행에 있어 이러한 핵심 기술로 평가되는 내용을 최대한 조사할 필요가 있다.
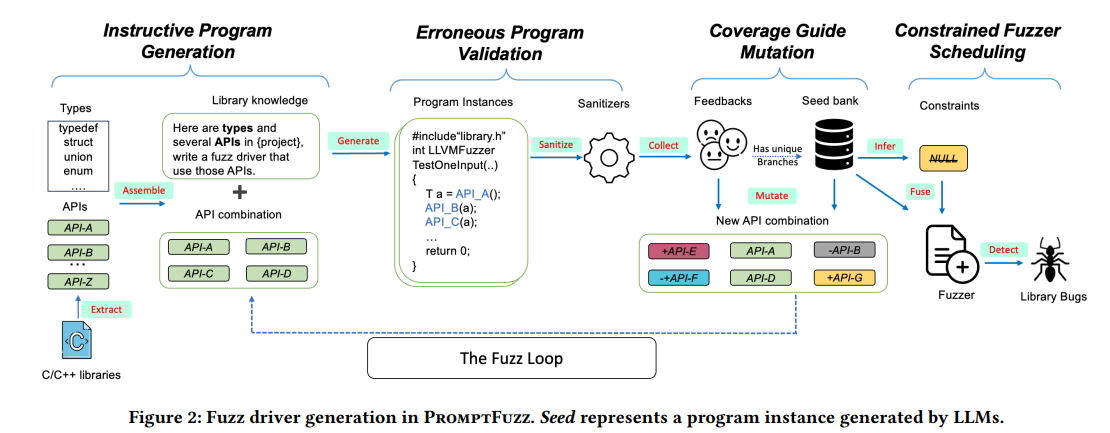
또 하나의 예시로, 2023년에 발표된 PromptFuzz(Prompt Fuzzing for Fuzz Driver Generation)를 예시로 볼 수 있을 것이다. PromptFuzz는 헤더(Header) 파일에서 API 함수와 관련된 타입을 파싱(Parsing)해 자동으로 하네스를 생성하는 방식으로 사전 준비 작업의 비용을 줄였다. 또한 기존 OSS-Fuzz-Gen이 단일 API에 대한 하네스를 생성했다면, PromptFuzz는 API 간의 상호작용에서 발생할 수 있는 오류까지 고려하여 API 시퀀스(Sequence) 단위로 하네스를 생성할 수 있게 되었다고 한다.
4.2. 오픈소스를 활용한 튜닝
OSS-Fuzz-Gen, PromptFuzz은 오픈소스이기 때문에, 이를 쉽게 활용할 수 있을 것이다. 요약에 서술된 바와 같이 만약 나 또한 OSS-Fuzz같은 중간자를 거치지 않는 개인 환경에서 독자적인 분석 환경을 구축하고, 기존의 LLM을 조금씩 튜닝하는 방향으로 진행할 것 같다.
4.3. 사용자 중심 학습
조사한 바에 따르면, 저랭크 적응(Low-Rank Adaptation, LoRA)방법론은 존의 전체 파라미터를 재학습하는 파인 튜닝에 비해 훨씬 적은 수의 훈련 가능한 파라미터를 사용함으로써, 계산 비용 및 메모리 요구사항을 크게 줄이는 데에 목적을 두고 있다고 한다. 하지만 해당 방법론을 사용해 Fine-tuning하는 것은 분명 단점도 있었을 것이다. 그래서 다른 방법론을 적용해 튜닝하는 방법은 없을까 조사해 보았다. 반대로 QLoAR을 수행하면 어떨까? 생각도 해 보았지만 조사 결과 on-premise환경에서는 그대로가 가장 나아 보였다.
5. 예상 산출물
- On-premise 환경에서 개발된 독자적인 FE, BE, LLM모델
- 현재 시장의 퍼징 테스트 LLM의 성능에 대한 다방면의 비교 지표
- 프로그램 프로토타입
- 연구 결과를 정리한 논문
6. 시행착오 예측
- 어찌 보면 해킹+자동화+AI의 3박자로 상당한 개발 지식과 자료조사가 필요했을 것이다. 해당 프로젝트는 팀으로 이뤄지겠지만 만약 나 혼자 한다고 했다면 LLM학습에만 몇년 공부하고 있었을 것이다.
참고문헌
- [1] Y.-J. Kim, Y.-J. Lee, and I.-G. Lee, “FuzzGPT: LLM Prompt Engineering-Based Fuzzing Technique for Test Case Optimization,” Journal of the Korea Institute of Information Security & Cryptology, vol. 34, no. 6, pp. 1517–1525, Dec. 2024.
- [2] S. An, S. Moon, J. Byun, S. Kang, J. Ham, S. Nam, J. Moon, and Y. Choi, “Development of LLM-based fuzzing test automation solution,” Proceedings of the Korea Computer Congress, Jeonnam, Korea, Dec. 18, 2024.
- https://www.dbpia.co.kr/journal/articleDetail?nodeId=NODE12042271
- https://theori.io/ko/blog/offensive-security-with-llm-part1
- https://theori.io/ko/blog/offensive-security-with-llm-part2
- https://arxiv.org/pdf/2312.17677
- https://www.databricks.com/kr/blog/efficient-fine-tuning-lora-guide-llms